[태그:] 유전자분석

  • 남녀 키 차이 원인, ‘Y 염색체’ 안에 있었다

    남녀 키 차이 원인, ‘Y 염색체’ 안에 있었다

    이미지 출처 : Motion Elements
    이미지 출처 : Motion Elements

    일반적으로 남성들은 여성에 비해 키가 크다. 실제 통계적으로 보면 평균 약 13cm 정도 차이가 나는 것으로 알려져 있다. 혹시 이런 현상에 대해 ‘왜?’라는 의문을 가져본 적이 있는가? 성별에 따른 차이에서 원인으로 꼽히는 것은 보통 ‘성 호르몬’이다. 여기에 더해, 최근 연구에서는 유전자, 즉 ‘성염색체’도 관여한다는 결과를 내놓았다. 남녀 키 차이 원인을 유전자 단위에서 밝혀낸 연구 결과, 그리고 그 의미에 대해 알아본다.


    성염색체 이상에서 발견한 특징

    생물학적으로 볼 때, 남성과 여성의 근본적인 차이를 만드는 것은 그리 많지 않다. 사실 일반인의 관점에서는 곰곰이 생각해본다 한들, 호르몬과 염색체 말고는 딱히 떠올릴 수 있는 것도 없다. 학계에서도 이 두 가지 요소에 대해 오랫동안 연구해왔지만, 여전히 밝혀지지 않은 것이 많았다. 지난 19일 미국 국립과학원 회보(PNAS)에 게재된 연구에서 그중 한 가지가 추가로 공개됐다.

    연구팀은 약 93만 명의 성인들을 대상으로 염색체 분석을 진행했다. 참가자들 중에는 ‘성염색체 이상(Sex Chromosome Aneuploidy, SCA)’을 가지고 있는 사람이 약 1천2백여 명 가량 포함돼 있었다. SCA는 유전적으로 성염색체 개수가 XX 또는 XY가 아니라, 그보다 많거나 적은 상태를 가리킨다. 

    예를 들어, 염색체가 더 적은 경우로는 여성에게 X 염색체가 하나만 있는 ‘터너 증후군(XO)’이 있다. 반대로 X 염색체 하나 더 많은 ‘삼중 X 증후군(XXX)’도 있다. 남성의 경우는 X 염색체가 하나 더 있는 ‘클라인펠터 증후군(XXY)’, 또는 Y 염색체가 하나 더 있는 ‘XYY증후군’ 등이 꼽힌다. 이로 인한 특징이나 심각성은 다양하게 나타나며, 눈에 띄는 증상이나 문제가 거의 없는 경우도 있다.

    연구팀은 SCA를 가지고 있는 1천2백여 명의 사람들을 조사하던 중 남녀 키 차이 원인으로 볼 수 있는 특이점을 발견했다. 특히 클라인펠터 증후군과 XYY 증후군인 사람들 사이에서 차이가 나타났다. 둘 다 남성에게 나타나는 증후군이지만, XYY 증후군인 경우 키가 더 많이 자란다는 사실을 확인한 것이다. 

    이는 남성 호르몬의 영향과는 무관하게 나타난 공통적 경향이었다. 즉, Y 염색체가 하나 더 있고 없고에 따른 차이라는 것이다. 남녀 키 차이 원인이 Y 염색체에 있을 수 있다는 가능성이 짙어지는 대목이다.

    남녀 키 차이 원인이 성 염색체에서 기인된다는 근거가 제기됐다 / 이미지 출처 : Motion Elements
    남녀 키 차이 원인이 성 염색체에서 기인된다는 근거가 제기됐다 / 이미지 출처 : Motion Elements


    Y 염색체가 남녀 키 차이 원인?

    Y 염색체가 남녀 키 차이 원인이 될 수 있다는 것은 어떤 원리일까? 연구팀은 X 염색체와 Y 염색체의 유전자 구조를 분석해 그 원인을 찾아냈다. 

    X 염색체와 Y 염색체는 기본적으로 ‘비상동성(non-homologous)’이다. 즉, 구조적으로 다른 부분이 많다는 뜻이다. 하지만 일부 똑같은 영역도 있다. 그중 하나가 바로 ‘SHOX 유전자’다. 연구팀이 분석한  바에 따르면, 바로 이 유전자가 키 성장에 관여하는 포인트다.

    여성은 XX 염색체를 갖는다. 이때 두 개의 X 염색체 중 하나는 대부분 비활성화된다. 이때 SHOX 유전자는 비활성화를 피해 살아남지만, 보통은 발현 수준이 비교적 낮아지게 된다. 반면, 남성의 경우 X와 Y 두 개의 염색체에서 SHOX 유전자가 모두 활성화된다. 

    연구팀은 바로 여기에 남녀 키 차이 원인이 있다고 보았다. 염색체 안의 유전자 발현 정도에 차이가 나면서, 뼈와 근육 등 근골격계 조직에 영향을 미치고, 그 결과로 남녀의 보편적인 키가 다르게 나타난다는 것이다.

    이를 검증하기 위해, 연구팀은 다양한 지역별, 인종별 인구 집단의 데이터를 분석했다. 그 결과, Y 염색체로 인해 남성과 여성의 평균적인 키 차이를 최대 22.6%까지 설명할 수 있다는 것을 발견했다. 

    이는 종종 성별에 따른 평균을 벗어나는 사례도 설명해준다. 예를 들어, 키가 상대적으로 작은 남성은 Y 염색체의 SHOX 유전자가 상대적으로 덜 발현된 것이며, 키가 큰 편인 여성은 비활성화된 X 염색체의 SHOX 유전자가 더 많이 발현된 사례로 설명할 수 있는 것이다.


    건강 전반에 대한 이해 확장

    이번 연구는 좁게 보면 단순히 남녀 키 차이 원인을 유전자 단위에서 밝혀냈다는 것으로 보일 수도 있다. 이는 대부분의 사람들에게는 그저 흥미 정도에 그칠 수 있는 주제다. 하지만 좀 더 시야를 확장해보면, ‘성별에 따른 생물학적 차이’를 유전자 수준에서 접근할 수 있게 됐다는 시사점을 제공한다.

    특히 다른 X 염색체와 Y 염색체가 본래 기본적으로 다른 구조를 가진다는 점, 이를 보다 세밀하게 분석함으로써, 구조적인 공통점과 차이점을 추려낼 수 있다는 점에 주목할 필요가 있다. 앞서 키 차이가 나타나는 원인을 밝혀냈듯, 이를 바탕으로 염색체의 유전자 차이로 인해 나타날 수 있는 다른 현상들도 설명해낼 수 있는 잠재력을 가지고 있다.

    예를 들어, 그동안 ‘성별에 따라 다르게 나타난다’라고 알려진 여러 가지 현상들, 또는 성별특이적 질환 등에 대해서도 납득 가능한 설명을 이끌어낼 수도 있을 것이다. 어쩌면 뇌 구조의 차이, 성격의 차이와 같은 보다 심화된 영역까지도 나아갈 수 있을지 모를 일이다.
    성별에 따른 생물학적 차이를 유전자 단위에서 밝혀낼 수 있는 단초를 제공한다 / 이미지 출처 : Motion Elements
    성별에 따른 생물학적 차이를 유전자 단위에서 밝혀낼 수 있는 단초를 제공한다 / 이미지 출처 : Motion Elements


  • 심부전 주요 원인 ‘심근병증’, 치료제 개발 가능성 열려

    심부전 주요 원인 ‘심근병증’, 치료제 개발 가능성 열려

    희귀·난치성 심근병증, 발병 단계·조직 손상 따라 달라지는 유전자 규명 / 출처 : 서울아산병원
    희귀·난치성 심근병증, 발병 단계·조직 손상 따라 달라지는 유전자 규명 / 출처 : 서울아산병원

    ‘심근병증(cardiomyopathy)’은 심부전을 일으키는 원인들 중에서도 매우 중요한 요인으로 꼽힌다. 치명적 질환인 심부전 주요 원인인 데다가, 사람마다 유형이 다양하고 발병 원인도 명확하게 밝혀지지 않아 난치성 질환으로 꼽힌다. 

    서울아산병원 연구팀이 심근병증의 원인이 되는 유전자를 밝혀내, 심근병증 표적 치료제 개발 가능성을 제시했다. 연구 결과는 <유럽 심장학회지(European Heart Journal, IF=38.1)>에 최근 게재됐다.


    심부전 주요 원인, 심근병증이란

    심근병증은 심부전 주요 원인으로, 심장이 제 기능을 하지 못하면서, 몸에 혈액 공급이 제대로 이루어지지 않는 질환이다. 이 때문에 평소 쉽게 숨이 차게 되고 금방 피로해진다. 다만, 심장이 제 기능을 하지 못한다는 결과가 같을 뿐, 그 구체적인 양상은 여러 가지로 나타난다. 

    심장근육이 약해지거나 얇아져 심실이 늘어나는 ‘확장성 심근병증’, 심장근육이 비정상적으로 두꺼워져 심실 내부 공간이 좁아지는 ‘비후성(비대성) 심근병증’, 심장근육 일부가 혈액을 공급하지 못하는 ‘허혈성 심근병증’ 등 유형이 다양하다. 이 또한 넓은 관점에서 분류한 것으로, 실제로 나타나는 유형들은 그 양상 등에 따라 훨씬 더 복잡하게 나뉜다.

    한편, 심근병증이 발생하는 근본적인 원인도 명확하게 밝혀진 바가 없다. 이 때문에 증상이 발생할 경우, 원인을 치료하기보다 심장이 약해질 때 나타나는 반응을 조절하는 방식으로 치료해왔다.


    심근병증 원인 유전자 발견

    서울아산병원 심장내과 이상언 교수와 병리과 황희상 교수 연구팀은 최근 이 문제를 해결하기 위한 연구를 진행했다. 심근병증을 앓고 있는 환자 37명을 대상으로, 심장조직 내 유전자 작동을 분석했다. 환자 37명과 대조군 7명의 심장조직을 활용, 총 1만2천8백 개의 유전자를 도출해 대규모 분석을 실시했다.

    분석 방법으로는 ‘공간 전사체학(Spatial Transcriptomics)’이 활용됐다. 세포 내 유전자 발현을 분석하는 기존의 기술에, ‘조직 내 위치 정보’를 결합한 최신 분석법이다. 

    공간 전사체학 분석법은 조직 내 정상부위 또는 손상 발생 부위 등 특정한 부위에서, 어떤 세포가 어떤 유전자를 발현하는지를 시각화할 수 있다. 즉, 조직이 손상되는 양상에 따라, 각 세포별 유전자 변화가 어떻게 이루어지는지를 보여준다. 

    이 기법을 활용해 분석한 결과, 연구팀은 심근병증 발병에 관여하는 유전자를 밝혀내는 데 성공했다. 여기에는 기존까지 심근병증과의 연관성이 잘 알려지지 않았던 유전자들도 포함됐다.


    심근병증 치료제 개발 기대

    이번 연구는 심장조직을 정밀하게 분석해 대규모의 유전자를 도출하고, 세포 구성 및 유전자 발현 단위에서의 차이를 규명한 최초 연구였다는 점에서 큰 의의를 갖는다. 심근병증 발병에 관여하는 유전자를 밝혀낸 만큼, 향후 심근병증 치료제 개발을 위한 실마리를 제공해줄 것으로 기대된다.

    병리과 황희상 교수는 “이번 연구를 바탕으로 심근병증의 병태생리 기반 정밀진단이 가능해지고, 향후 정밀의학 기반 맞춤치료제 개발에도 큰 단서를 제공할 것으로 기대된다”라고 말했다.

    심장내과 이상언 교수는 “심근병증은 급사의 원인이 될 수 있는 심부전 주요 원인임에도 불구하고, 현재까지 심장 기능 저하에 따른 공통된 반응을 조절하는 데 초점이 맞춰져 있었다”라며, 심근병증의 다양한 병리적 양상과 세포 반응을 정밀 분석할 수 있는 기반 데이터를 구축한 데 의의가 있으며, 이를 바탕으로 심근병증 자체를 표적으로 하는 치료제 개발로 이어질 수 있도록 연구를 지속하겠다”라고 말했다.

    한편, 이번 연구는 미국 의학연구소인 스크립스 연구소(Scripps Research), 그리고 카이스트(KAIST, 한국과학기술원)와 공동으로 진행됐다. 연구는 보건복지부의 ‘연구중심병원 육성 연구개발 사업과제’ 지원을 받아 시행됐다.

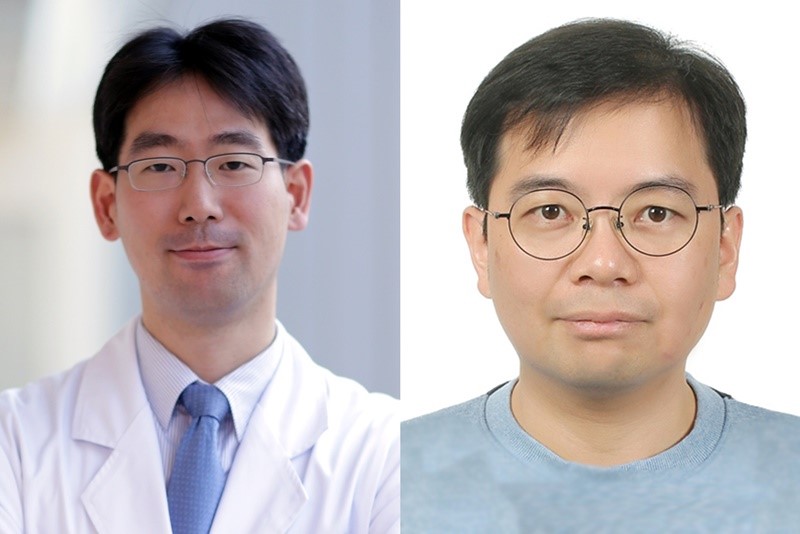
    서울아산병원 심장내과 이상언 교수(좌)와 병리과 황희상 교수(우) / 출처 : 서울아산병원
    서울아산병원 심장내과 이상언 교수(좌)와 병리과 황희상 교수(우) / 출처 : 서울아산병원


  • 알츠하이머 조기 진단, 혈액 속 유전자 변화로 가능할 것

    알츠하이머 조기 진단, 혈액 속 유전자 변화로 가능할 것

    이미지 출처 : Motion Elements
    이미지 출처 : Motion Elements

    국내 연구팀이 혈액 검사를 통해 알츠하이머 조기 진단이 가능할 수 있다는 연구 결과를 제시했다. 혈액 속에서 알츠하이머 진행과 밀접한 유전자 발현 변화가 일어난다는 것을 밝혀낸 것이다.


    현행 알츠하이머 검사법의 한계

    알츠하이머는 치매의 가장 흔한 유형으로 꼽힌다. 기억력 감퇴와 인지 기능 저하를 유발하는 퇴행성 뇌질환으로, 일단 시작되면 뇌에 되돌릴 수 없는 손상을 일으킨다. 이 때문에 알츠하이머 조기 진단은 원활한 치료 및 관리에 있어 무척 중요하다.

    하지만 현실적으로 대부분의 환자들은 병이 상당히 진행된 뒤에야 진단을 받는다. 여러 이유가 있겠지만, 가장 큰 이유는 알츠하이머 조기 진단을 위한 검사 부담이 크다는 것이다. 현재 알츠하이머 진단을 위해서는 PET(양전자방출단층촬영) 검사가 널리 시행된다. 정확도가 높은 검사법이지만, 의료기관에 따라 백만 원 이상의 비용이 필요해 부담이 큰 편이다.

    한편, 뇌척수액 검사를 시행하기도 하는데, 이는 마취 후 척추의 허리 부분(요추)에 바늘을 삽입해 척수액을 채취하는 침습적 검사 방식이다. PET 검사에 비하면 비용은 저렴하지만, 신체적으로 부담이 상당한 검사법이다. 검사 후 통증 등 부작용이 발생할 수 있고, 회복까지 시간도 많이 걸리는 편이다. 이로 인해 두 가지 검사법 모두 일상적으로 활용하기에는 한계가 있다.

    뇌척수액 검사는 비용은 저렴하지만 침습적 검사 방식으로 신체적, 시간적 부담이 큰 편이다 / 출처 : 서울아산병원
    뇌척수액 검사는 비용은 저렴하지만 침습적 검사 방식으로 신체적, 시간적 부담이 큰 편이다 / 출처 : 서울아산병원


    혈액 검사로 알츠하이머 조기 진단 가능성

    분당서울대병원 신경과 박영호 교수 연구팀은 순천향대서울병원, 미국 인디애나 대학 연구팀과 협력해 이러한 문제를 해결하고자 했다. 이른바 알츠하이머 조기 진단을 위한 장벽을 낮추고자 한 것이다.

    최근 혈액 검사를 통해 다양한 질병의 조기 진단이 가능하다는 사례가 여럿 공개되고 있다. 이에 연구팀은 간단한 혈액 검사를 통해 알츠하이머 발병을 조기에 포착할 수 있는지를 확인하고자 했다. 연구는 분당서울대병원 및 서울대병원에 등록된 알츠하이머 환자 523명의 혈액 샘플을 토대로 진행했다. RNA 시퀀싱 기법을 활용해 혈액 속 유전자 발현 양상을 분석하는 방식이다.

    분석 결과, 환자들의 혈액 샘플에서는 정상과 다른 유전자 발현이 나타났다. 또한, 발병 시기에 따라 다른 양상으로 발현되는 유전자 개수도 달랐다. 65세 이전에 알츠하이머가 발병한 환자(조기 발병 환자)의 경우 18개, 65세 이후에 발병한 환자(후기 발병 환자)의 경우 88개 유전자가 정상과 다른 발현을 보였다.


    알츠하이머 발병 시기와 유전자 발현 차이

    특히 후기 발병 환자의 경우 SMOX, PLVAP라는 유전자의 활성도가 크게 감소했다. 연구팀에 따르면 이들 유전자는 알츠하이머의 주요 원인으로 지목되는 아밀로이드 베타 단백질의 축적과 연관성이 깊다.

    또한, 연구팀은 후기 발병 환자들에게서 몇 가지 유전자가 제대로 작동하지 않는 경향이 있다는 것도 발견했다. 대표적인 것은 ▲뇌세포 에너지 조절(AMPK 신호전달경로) ▲손상된 단백질 제거(유비퀴틴 매개 단백질 분해) ▲세포 내 청소 작용(미토파지) 등과 관련된 유전자들이다. 연구팀은 이를 바탕으로 알츠하이머의 병리 메커니즘을 보다 정밀하기 이해할 수 있을 것으로 보고 있다.

    이러한 결과는 알츠하이머의 발병 시기에 따라 서로 다른 유전자 발현 특성을 보인다는 사실을 보여준다. 즉, 혈액 속 유전자 발현 정보를 통해 알츠하이머 환자의 특징을 구별할 수 있다는 것이다. 연구팀은 이것이 알츠하이머 조기 진단을 위한 단서가 될 수 있으며, 결과에 따른 맞춤형 치료 전략을 개발에도 활용할 수 있을 것으로 보고 있다.

    이번 연구 결과는 알츠하이머병협회(Alzheimer’s Association)에서 발행하는 공식 학술지 <알츠하이머와 치매(Alzheimer’s & Dementia, IF=13.1)> 2월호에 게재됐다.

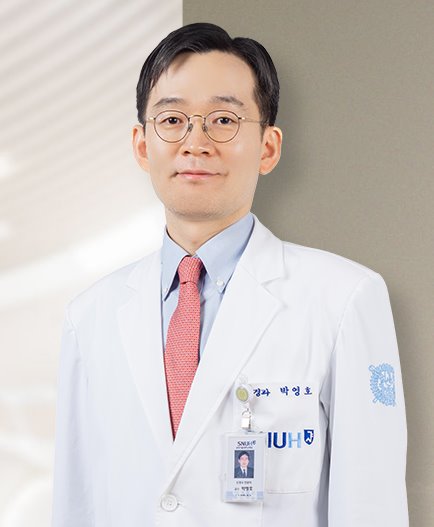
    분당서울대병원 신경과 박영호 교수 / 출처 : 분당서울대학교병원
    분당서울대병원 신경과 박영호 교수 / 출처 : 분당서울대학교병원


  • 소변 검사만으로 방광암 진단 가능해진다

    소변 검사만으로 방광암 진단 가능해진다

    ※ 위 이미지는 본문 내용과 직접적인 연관이 없음 / Designed by Freepik
    ※ 위 이미지는 본문 내용과 직접적인 연관이 없음 / Designed by Freepik

    국내 연구팀이 학교-병원-산업 연계 공동연구로 내시경 없이 방광암을 진단하는 기술을 개발했다. 환자의 소변에서 분리한 세포 펠렛 DNA를 활용하는 것으로, 비침습적 방식으로 환자 부담도 없고, 비용도 저렴한 것이 특징이다.


    소변에서 분리한 cpDNA 분석

    건국대학교 줄기세포재생공학과 조쌍구 교수 연구팀과 건국대학교병원 비뇨기과 김아람 교수, 그리고 조쌍구 교수가 대표이사로 있는 바이오기업 스템엑소원(주)은 유전자 변이 분석을 토대로 방광암을 진단하기 위한 기술 연구를 진행했다.

    연구팀은 ‘비근육침윤성 방광암(NMIBC)’ 환자의 소변을 원심분리해 ‘세포 펠렛 DNA(cpDNA)’를 확보한 다음, 차세대 염기서열 분석(NGS)을 통해 유전자 변이를 분석했다. 그 결과, 암 조직과 cpDNA 간 높은 유사성을 확인했다. 

    또한, FGFR3, TTN, LEPROTL1 등 방광암 관련 주요 유전자에서 돌연변이가 발견됐다. 특히 종양 돌연변이 부담(TMB)을 비교한 결과, 소변 cpDNA와 암 조직 간 유의미한 차이가 없었다. 이는 cpDNA가 방광암 조기 진단 및 재발 감시 용도로 활용될 수 있다는 의미다.


    소변 검사로 방광암 진단 가능

    현재 방광암을 진단하기 위해서는 요로를 통해 몸속에 기기를 넣는 ‘방광내시경 검사’ 또는 조직검사가 주로 사용된다. 이들은 모두 환자에게 물리적인 부담이 있는 방법이며, 검사를 위한 비용도 상당하다. 

    반면, 연구팀이 이번에 개발한 cpDNA 기반 분석법은 소변 샘플만 가지고도 암 발생 여부를 확인할 수 있다. 일반적인 건강검진에서처럼 소변 샘플만 제출하면 검사를 통해 진단할 수 있다는 것이다. 통증이나 위험 부담 없이 정밀한 진단이 가능하고, 비용도 매우 저렴하다. 

    이는 혈액 검사를 기반으로 다양한 진단이 가능해지고 있는 최근 진단검사 트렌드에도 부합한다. cpDNA를 분석하는 기술은 향후 방광암 외의 다양한 질환을 조기에 진단하는 데도 폭넓게 활용될 수 있을 것으로 기대된다.

    이번 연구는 병리학 분야 국제학술지인 <실험실 연구(Laboratory Investigation)>에 이달 초인 3일(월) 온라인 게재됐다.

    (왼쪽부터) 건국대 석재권 박사, 곽희정 연구원, 김아람 건국대 병원 교수, 조쌍구 건국대 교수 겸 스템엑소원 대표이사
    (왼쪽부터) 건국대 석재권 박사, 곽희정 연구원, 김아람 건국대 병원 교수, 조쌍구 건국대 교수 겸 스템엑소원 대표이사


  • 질병 원인 유전자 찾아내는 AI 시스템 개발

    질병 원인 유전자 찾아내는 AI 시스템 개발

    ※ 위 사진은 본문 내용과 직접적 연관이 없음 / Designed by Freepik
    ※ 위 사진은 본문 내용과 직접적 연관이 없음 / Designed by Freepik

    부산대학교 연구팀이 특정 질병과 연관성이 높은 유전자를 발굴하는 데 있어 한 단계 더 나아간 AI 시스템을 개발했다. 이를 바탕으로 환자별 맞춤 치료를 제공하는 ‘정밀 의료 시대’가 더욱 앞당겨질 것이라는 기대가 커지고 있다.


    질병 치료 보조하는 AI 시스템

    인공지능(AI)의 적용이 확산되면서, 의료 분야에서도 다양한 방법으로 AI가 활용되고 있다. 특히 최근에는 특정 질환과 연관성이 높은 유전자를 발굴하는 작업에서도 AI가 두각을 나타내고 있다. 이 분야에서의 AI는 기존까지 특정 유전자가 질병과 연관성이 있는지를 예측해내는 정도였다. 

    부산대학교 연구팀은 최근 여기서 한 발 더 나아간 AI 시스템을 선보였다. 유전자와 질병의 연관성 예측과 함께, 해당 유전자가 질병 치료를 위한 표적이 될 수 있는지, 혹은 생체 지표로서 기능할 수 있는지까지 예측할 수 있는 방식이다.

    부산대학교 정보컴퓨터공학부 송길태 교수는 부산대학교병원 순환기내과 이혜원 교수와의 공동연구를 통해 이와 같은 시스템을 개발했다. 특정 유전자가 질병의 발생 여부나 진행 정도를 평가할 수 있는지, 혹은 특정 유전자를 조작하거나 수정함으로써 해당 질병을 치료할 수 있는지를 AI가 판단할 수 있는 방식이다. 이는 질병의 조기 진단 및 예후를 예측할 때 중요한 정보가 된다.


    유전자 간 복합적 상호작용 분석

    질병은 보통 개인이 가지고 있는 유전적 요소들이 복합적으로 작용함으로써 발생한다. 하나의 질병은 여러 유전자들이 상호작용한 결과이기 때문에, 단순히 ‘질병과 유전자의 연관성’만 예측하는 것으로는 부족하다. 상호작용한 유전자들 가운데는 해당 질병과 보다 연관성이 높은, 혹은 보다 직접적으로 연관돼 있는 유전자가 있을 것이기 때문이다.

    이에 연구팀은 유전자 간 상호작용을 통합적으로 반영하는 접근법을 채택했다. 상호작용 과정을 세밀하게 분석함으로써, 어떤 유전자가 질병의 바이오마커(생체 지표)가 될 수 있는지, 어떤 유전자가 치료 표적이 될 수 있는지를 예측할 수 있을 거라는 관점이었다.

    연구팀은 ‘하이퍼그래프(Hypergraph)’와 ‘어텐션(Attention)’ 알고리즘을 사용했다. 질병에 관여하는 다양한 생물학적 요소들 사이에 어떤 상호작용이 일어나는지를 모델링하고, 이를 연산해 시각화함으로써 예측 결과에 대한 설명도 제공한다.


    질병 원인 제거하는 정밀 의료 가능성

    연구팀은 생물학 전문가들에 의해 큐레이션된 오픈소스 데이터베이스(DB)를 활용해, 개발한 AI 시스템을 검증하고자 했다. DB에서 유전자, 질병, 인간 표현형 온톨로지 등에 관련된 데이터를 확보해 시스템 검증을 진행했다.

    송길태 교수는 “이번에 개발한 AI 시스템을 활용하면, 단시간 내 특정 질병을 치료하기 위한 유전자 후보군을 발굴할 수 있다”라며 “이를 기반으로 질병을 유발하는 유전자에 직접 작용해, 질병의 근본적인 원인을 제거하는 정밀 의료에 한 걸음 더 다가갈 수 있을 것”이라고  설명했다.

    연구팀은 이 시스템에 대한 국내 특허 출원을 완료했다. 한편, 부산대학교 산학협력단의 지원을 받아 미국에서의 특허 출원도 진행 중이다. 이번 연구 성과는 영국 옥스퍼드 대학에서 발간하는 국제 학술지 「생명정보학 브리핑(Briefings in Bioinformatics)」에 지난 1월 22일 게재됐다.


    연구 개념도 / 출처 : 부산대학교
    연구 개념도 / 출처 : 부산대학교


  • 한국인 맞춤형 정밀의료 데이터베이스 구축 시작

    한국인 맞춤형 정밀의료 데이터베이스 구축 시작

    국가통합 바이오 빅데이터 구축사업 개요 / 출처 : 보건복지부 보도자료
    국가통합 바이오 빅데이터 구축사업 개요 / 출처 : 보건복지부 보도자료

    ‘국가통합 바이오 빅데이터 구축사업’ 출범식이 금일(19일) 오후 1시 서울 엘타워에서 개최됐다. 금일 출범식에는 관계부처인 보건복지부, 과학기술정보통신부, 산업통상자원부, 질병관리청 관계자를 비롯해, 서울대학교병원, 서울아산병원, 삼성서울병원 등 총 38개 의료기관 관계자들이 참석했다.


    글로벌 격차 해소 목적

    국가통합 바이오 빅데이터 구축사업은 국민들의 자발적인 참여 및 동의를 기반으로 각종 의료 데이터를 통합·관리하기 위한 사업이다. 우리나라 사람들이 주로 어떤 질환에 자주 걸리는지, 해당 질환이 자주 발병하는 이유는 무엇인지에 대해 명확한 분석을 목표로 하고 있다. 이를 통해 국민들의 질병 발생 가능성을 사전에 예측함으로써 공중보건 증진에 기여하겠다는 목적이다.

    실제로 해외 여러 대학이나 연구기관에서 건강 이슈나 각종 질환에 관해 거의 매일 새로운 연구 결과를 내놓고 있다. 그중 어떤 연구들은 전 세계적으로 충분한 보편성을 가지고 있는 반면, 또 어떤 연구 결과들은 특정 인종, 특정 국가에만 국한된 연구를 내놓는 경우도 많다.

    특히 영국 바이오뱅크의 경우, 2006년부터 2010년까지 50만 명의 데이터 확보를 완료했으며, 현재까지도 이를 바탕으로 다양한 연구를 수행해 유의미한 성과를 거두고 있다. 영국은 이를 토대로 500만 명 규모의 게놈사업으로 확대를 추진 중이다.

    바이오뱅크의 데이터를 기반으로 얻은 연구 결과 역시 도움이 되는 경우도 있지만, 우리나라 사람들에 특화돼 있는 바이오 데이터를 기반으로 하는 편이 더 정확도 높은 성과를 낼 수 있음은 자명한 일이다.

    한편, 미국 역시 2018년부터 시작해 오는 2026년까지 ‘All of US’라는 이름으로 바이오 데이터베이스 구축사업을 추진 중이다. 현재 65만 명이 모집됐으며 2026년까지 100만 명 모집을 목표로 하고 있다. 이러한 배경에서 의료 및 바이오 분야의 글로벌 격차를 해소하기 위한 방안의 필요성이 대두됐다.


    한국인 특화 의료 데이터베이스

    국가통합 바이오 빅데이터 구축사업은 이러한 배경으로 시작됐다. 국가가 주도하여 우리나라 사람들에게 특화된 의료 데이터베이스를 구축하기 위한 사업이다. 의료 및 바이오 분야에서의 글로벌 경쟁력을 강화하기 위해 정부가 주도하고 국민들의 참여로 완성한다는 통합형 프로젝트인 셈이다.

    국가통합 바이오 빅데이터 구축사업은 올해 3월 28일(목) 정부 관계부처 주관으로 사전 설명회를 개최했으며, 4월 8일(월) 보도자료를 통해 사업을 이끌어갈 사업단장으로 서울대학교 의과대학 백롱민 교수를 선정했다고 발표한 바 있다. 그리고 금일 출범식을 통해 본격적인 가동을 시작했다. 

    당초 발표한 계획대로 오는 2028년까지 1단계 사업을 추진하며, 이 기간 동안 총 77.2만 명의 참여자를 모집한다는 계획이다. 이후 2029년부터 2032년까지 다시 4년에 걸쳐 추가 모집을 진행, 총 100만 명 규모의 바이오 빅데이터를 구축하겠다는 목표를 가지고 있다.

    희귀질환자 및 중증질환자 사업 참여 방법 / 출처 : 국가통합 바이오 빅데이터 구축사업단 홈페이지
    희귀질환자 및 중증질환자 사업 참여 방법 / 출처 : 국가통합 바이오 빅데이터 구축사업단 홈페이지
    일반국민 참여자 사업 참여 방법 / 출처 : 국가통합 바이오 빅데이터 구축사업단 홈페이지
    일반국민 참여자 사업 참여 방법 / 출처 : 국가통합 바이오 빅데이터 구축사업단 홈페이지


    어떤 정보를 제출하는가?

    국가통합 바이오 빅데이터 구축사업은 개인의 유전체 단위 정보를 모으고 분석하기 위한 프로젝트다. 이를 통해 개인의 동의 하에 검체를 확보하고, 이를 바탕으로 임상 및 유전체 데이터를 작성한 다음, 공공 데이터와 라이프 로그(Life Log, 개인의 일상활동, 경험, 감정, 건강, 운동, 식사 등에 대한 기록)를 수집하여 ‘통합 데이터(Integrated Data)’를 구축하게 된다.

    사업단 홈페이지(https://www.biobigdata.kr)를 통해 사업에 대한 보다 자세한 설명 및 구체적인 참여 방법을 확인할 수 있다. 전국 38개 모집기관 중에서 △희귀질환자 △중증질환자 △일반 참여자 중 해당하는 유형에 맞는 모집기관을 방문하여 참여 절차를 진행하면 된다.

    희귀질환자는 삼성서울병원, 서울대학교병원, 서울아산병원 3개 기관에서만 모집하며, 중증질환자는 위 3개 기관을 포함해 고려대학교병원, 서울성모병원, 신촌세브란스병원, 이화여대목동병원, 분당서울대병원, 양산부산대병원 등에서 모집한다. 국립암센터와 서울성모병원에서는 암 특화 중증질환자를 함께 모집한다. 그 외의 일반 참여자들은 각 지역별 3차 의료기관을 통해 참여할 수 있다.

    이번 1단계 모집은 동의서와 설문을 작성한 다음 혈액 및 소변을 채취하는 방식으로 이루어진다. 희귀질환자나 중증질환자의 경우 채혈이 불가능한 상황이라면 타액을 채취하게 된다. 수집된 데이터 및 검체는 데이터뱅크(한국보건의료정보원 인체유래물은행) 및 바이오뱅크(질병관리청 국립중앙인체자원은행)를 통해 안전하게 보관되며, 향후 정밀의료 및 디지털 헬스케어 연구·개발 목적으로 활용될 예정이다. 보관된 데이터는 대학 및 병원 등을 대상으로 2026년부터 개방된다.

    출처 : 보건복지부 보도자료
    출처 : 보건복지부 보도자료


    <본 기사는 보건복지부에서 2024년 12월 19일 작성하여 공공누리 제1유형으로 개방한 자료를 활용하여 작성되었습니다.>

  • ‘국가 통합 바이오 빅데이터 구축 사업’, 한국인 맞춤형 정밀의료체계 만든다

    ‘국가 통합 바이오 빅데이터 구축 사업’, 한국인 맞춤형 정밀의료체계 만든다

    출처 : 국가 통합 바이오 빅데이터 구축 사업 홈페이지

    인간은 ‘왜’ 병에 걸릴까? 

    무척 난해하게 느껴질 수 있는 질문이다. 병이라 규정된 것들도 한두 가지가 아닌 데다가, 어떤 병들은 ‘특발성 질환’이라 하여 뚜렷한 원인이 밝혀지지 않은 경우도 있기 때문이다. 하지만 이론적으로 봤을 때 질병이 발생하는 원리 자체는 어느 정도 밝혀져 있다. 그 중 한 예가 바로 우리 몸 속의 선천적인 유전체 이상으로 인해 질병이 생기는 경우다. 예를 들어, 자녀는 부모로부터 각각 유전체 일부를 물려받게 되는데, 이렇게 전해진 유전체 중 일부분에 이상이 생길 경우 특정 질병에 취약해질 가능성이 높아진다.

    물론 모든 질병이 선천적 가능성에 의해서만 발생하는 것은 아니다. 일란성 쌍둥이가 서로 다른 환경에서 성장할 경우, 서로 다른 질병에 걸린다는 것 또한 이미 입증돼 있는 사실이다. 생활습관, 식습관, 특정 환경에의 장기간 노출 등과 같은 후천적 요인 역시 질병 발생의 원인이 된다는 것이다.

    이처럼 질병의 발생 이면에 존재하는 복합적인 요인을 밝혀내기 위해, ‘국가 통합 바이오 빅데이터 구축 사업’이 진행 중이다.


    국가 통합 바이오 빅데이터 구축 사업은 무엇인가?

    국가 통합 바이오 빅데이터 구축 사업이란, 한국인을 대상으로 한 ‘바이오 빅데이터’를 구축하기 위한 사업이다. 우리나라 사람들이 주로 어떤 병에 취약한지, 그 원인이 무엇인지 등을 유전체 단위까지 분석함으로써 질병의 발생 가능성을 사전에 예측할 수 있도록 한다는 목적으로 진행되는 정부 주도&국민 참여 사업이다. 

    여기서 말하는 바이오 빅데이터에는 개인의 건강정보와 임상정보, 오믹스 데이터*, 공공 데이터 등이 포함된다. 이들 데이터를 통합하여 빅데이터를 구축하고 이를 연구 목적으로 활용해 정밀의료 기술개발 등 의료 분야 혁신을 도모한다는 연구개발(R&D) 목적의 사업인 것이다. 

     ** 오믹스(Omics) 데이터 : 유전체(Genome), 후성유전체(Epigenome), 전사체(Transcriptome), 단백체(Proteome), 대사체(Metabolome), 미생물군유전체(Microbiome) 등 생물 유래의 집합체를 총칭하는 말. ‘-ome’는 집합체(집단, 묶음)를 의미하는 접미어.

    흔히 말하는 ‘개인차’에는 유전자와 같은 선천적 요소는 물론 생활환경, 습관과 같은 후천적 요소도 포함된다. 이러한 개인차 요소를 비롯해 개인의 임상정보, 유전정보 등을 폭넓게 수집하여 비교·분석할 수 있다면, 질병의 발생을 예방하거나 발병하더라도 보다 빠르고 정확한 치료가 가능해질 것이다. 

    출처 : 국가 통합 바이오 빅데이터 구축 사업 홈페이지

    바이오 빅데이터 구축, 무엇을 기대하는가?

    인간의 유전체를 연구하고자 한 사례는 그리 새롭지 않다. 흔히 선진국으로 꼽히는 국가들이라면 관련 프로젝트를 수행한 이력을 어렵지 않게 찾아볼 수 있다. 하지만 인종이 다르고 민족이 다르면 기본적인 생김새부터 시작해 많은 것이 다르다. 당연히 유전체 서열도 다를 수밖에 없다. 이는 굳이 학술적으로 면밀하게 규명하지 않더라도 여러 가지 측면에서 이미 알려져 있는 사실이다. 

    실제로 세계보건기구(WHO) 등을 통해 확인할 수 있는 질병 통계와 건강보험심사평가원의 질병 관련 통계를 비교해보면 서로 다르게 나타나는 것들이 많다는 것을 알 수 있다. 국가별 질병 순위, 사망 원인이 되는 질병 순위 등이 그 대표적인 예다.

    국가 통합 바이오 빅데이터 구축 사업은 ‘한국인의 유전정보’를 모으고 분석해, ‘한국인 표준 유전체’를 구축하기 위한 프로젝트다. 다른 나라의 유전체 연구 사례와 달리, 오직 우리 민족에 특화된 유전정보를 밝혀내기 위한 것이다. 이를 통해 우리나라 사람들이 주로 어떤 질병에 잘 걸리는지, 어떤 질병에 취약한지, 그에 영향을 미치는 선천적 요건이나 후천적 요인은 무엇인지 등을 밝혀낼 수 있을 것으로 기대하고 있다.

    특히 희귀질환으로 분류되는 질병들에 대한 성과가 이번 사업의 주목 포인트다. 우리나라에서는 전체 인구 중 같은 질병을 앓는 환자가 2만 명 이하일 때 그것을 희귀질환으로 분류한다. 이러한 희귀질환들은 대략 80% 정도가 유전적 이상으로 인해 발생하는 것으로 알려져 있다. 이번 바이오 빅데이터 구축 사업을 통해 표준 한국인의 유전체 검사가 충분히 이루어진다면, 희귀질환의 예방 및 치료에 있어 획기적인 성과를 거둘 수 있을 것이라 기대된다.

    본질적으로 빅데이터는 기반이 되는 리소스가 많을수록 결과물의 품질도 높아질 수밖에 없다. 국가 통합 바이오 빅데이터 구축 사업 또한, 개인의 유전체 정보가 많이 모일수록 정밀도가 높아진다. 작년 6월 예비타당성 조사를 통과하면서 국가가 앞장서 주도하며 국민들의 적극적인 참여를 호소하는 근본적인 이유다. 그 일환으로 지난 3월 28일(목) 정부 관계부처들의 주관으로 국가 통합 바이오 빅데이터 구축 사업의 사전설명회가 열린 바 있다. 이 자리에서는 2024년부터 2028년까지 5년에 걸쳐 약 77만 명의 의료 데이터를 수집하겠다는 목표를 밝혔다. 

    출처 : 국립보건연구원 홈페이지

    민감한 개인정보, 어떻게 관리할 것인가?

    취지와 목적, 모두 좋다. 다만, 가장 문제가 되는 부분은 개인정보에 관한 이슈다. 병원 진료기록을 비롯한 건강 관련 정보는 개인정보 중에서도 매우 민감한 항목에 속한다. 의료인 또는 의료기관 종사자들은 이러한 정보에 대해 철저한 보안을 지키도록 법으로 정해져있기도 하다.

    국가 통합 바이오 빅데이터 구축 사업을 위해서는 이러한 개인의 건강 관련 정보의 수집이, 그것도 수십만 명 이상의 많은 사람들의 민감정보 수집이 필요하다. 정부가 주도하지만 국민들의 참여를 강조하고 호소하는 근본적인 이유다. 일반적으로 자신의 의료기록이 노출되는 것을 달가워 하는 사람은 없을 것이기에, 정부 차원에서 개인이 제공한 데이터를 보호하고 철저하게 관리한다는 점을 강조하고 있다. 이를 위해 보건복지부와 질병관리청, 과학기술정보통신부, 산업통상자원부 등 여러 정부부처들이 협력한다는 방침이다. 또한, 연구 목적으로 활용한다는 것 또한, 연구윤리위원회로부터 ‘공공 목적을 위한 연구’를 승인 받은 경우에만 구축된 빅데이터를 이용할 수 있도록 통제한다는 계획이다.

    현재 국가 통합 바이오 빅데이터 구축 사업에는 한국생명공학연구원, 한국과학기술정보연구원, 한국산업기술평가관리원, 한국보건산업진흥원 등 정부출연 연구기관들이 참여하고 있다. 소위 ‘빅5’ 병원을 비롯해 전국 17개 대학병원도 시범사업에 함께 참여 중이다.

    보건복지부는 8일(월) 보도자료를 통해 국가 통합 바이오 빅데이터 구축 사업단장으로 서울대학교 의과대학 백롱민 교수를 선정했다고 밝혔다. 오직 한국인을 위한 유전정보 풀을 구축하고, 이를 토대로 데이터 기반 정밀의료 체계를 구축하겠다는 이번 사업이 어떻게 진행될 것인지 주목해본다.

    출처 : 국가 통합 바이오 빅데이터 구축 사업 공식 유튜브
    출처 : 국가 통합 바이오 빅데이터 구축 사업 공식 유튜브


회사소개 · 이용약관 · 개인정보처리방침 · 청소년보호정책 · 저작권보호정책 · 이메일무단수집거부

헬스라이프헤럴드 | (주)메이븐크리에이티브 | 경기도 광주시 초월읍 설월길 45-13 2층

대표전화 070-8890-5653 | 이메일 healthlifeheraldnews@naver.com

인터넷신문 등록번호 경기 아 53970 | 등록일 2024-02-21 | 발행인·편집인 나지홍 | 청소년보호책임자 나지홍

Copyright © 헬스라이프헤럴드. All rights reserved.